林业遥感项目常被问到一个看似简单的问题:这片区域到底有多少棵树?从卫星影像输出一个整数很容易,难的是交代这个数代表什么。孤立树有时能在高分辨率影像中定位,密林里树冠却会相互覆盖;航空激光雷达可以规模化生成候选点,但候选点并不等同人工确认的树中心。若把这些差异压成一张“精确树位”图,误差会被伪装成资产事实。
TreeMatch 的论文于 2026 年 6 月 23 日首次提交 arXiv,当前记录显示 v2 更新于 6 月 25 日。它把卫星树木计数作为一个带噪声监督的问题处理:不强迫模型为每个模糊树冠给出确定边界,而是学习空间上的树木密度,并为监督本身保留不确定性。
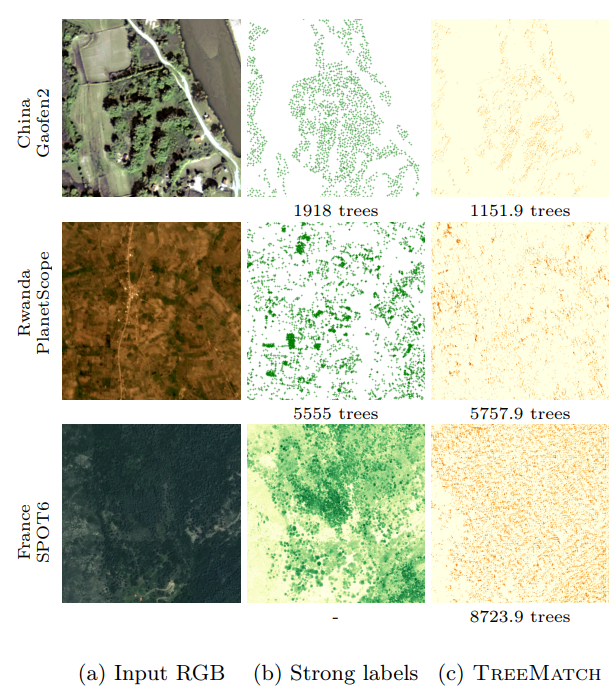 TreeMatch 的强弱标注与密度预测
图:官方 TreeMatch 仓库的模型示意,展示卫星影像、人工强标注、激光雷达衍生弱标注与预测密度图。
可核查事实
- 论文将训练表述为非平衡最优传输约束下的空间密度匹配。
- TreeMatch 利用传输残差在训练中逐步修正噪声监督。
- TinyTrees v1 覆盖三大洲、三种卫星传感器,面积超过 23,000 平方千米,包含超过 2.15 亿树木标注,其中 77.3 万为人工核验实例。
- 三种传感器的地面采样距离范围为 0.8—4.2 米。
- 论文图区分人工树中心的强标注、航空激光扫描自动获得的弱标注,以及按像素输出的树木密度图。
- 官方代码的数据图块为五波段 GeoTIFF:四个光谱波段与一个二值有效像元掩膜。
- 点标注以 GeoPackage 保存,并用
tile字段关联图块和标注。 - 官方仓库说明 PlanetScope 与高分影像为 CC BY-NC 4.0 的研究教育用途资源。
可核验事实:数据口径
论文于 2026 年 6 月 23 日首次提交 arXiv,当前记录显示 v2 更新于 2026 年 6 月 25 日。
论文把树木计数表述为由非平衡最优传输监督的空间密度匹配问题,并使用传输残差在训练过程中逐步修正噪声监督。
论文 HTML v1 将 TinyTrees 描述为跨三大洲和三种卫星传感器、覆盖超过 23,000 平方千米、包含 215 million 以上树木标注(其中 773,000 个为人工核验实例)的基准;三种传感器的地面采样距离范围为 0.8 米至 4.2 米。
官方代码则说明每个图块是四个光谱波段加一个二值有效像元掩膜的五波段 GeoTIFF,点标注保存在 GeoPackage 并通过 tile 字段关联影像。
核心机制:允许标注与现实不完全相等
传统检测器通常假设每一个训练点都准确对应一个可分开的目标;密度回归则可能把模糊区域平滑掉。TreeMatch 选择非平衡最优传输,是因为弱标签可能漏点、多点或位置偏移。模型输出的是逐像元树木密度图:在孤立树区域可以支持较精细的定位,在密林中则更适合表达总量和空间分布。
论文还用传输残差做自校正。直观地说,模型不把弱标签当成不可质疑的真值,而是根据匹配中暴露的不一致逐步调整训练目标。这个机制不会让噪声消失;它只是把“标签也会错”纳入学习过程。因此最终交付仍要说明哪些位置来自人工强标注、哪些来自 LiDAR 衍生弱标注、哪些只是模型估计。
GIS 场景:把数量、密度和树位拆开交付
碳汇核算、城市绿化盘点和农林复合系统监测都可能需要树木数量,但不同用途的误差成本不同。区域级指标可以使用分区汇总的密度和置信区间;巡查任务则需要单棵候选点与人工影像复核;更新树冠面图还需要独立的分割与几何质检。它们不应共用同一张没有语义字段的“树木图层”。
数据产品至少应分为三层:原始影像及有效像元掩膜;点标注与其来源等级;模型密度栅格及按行政区、样地或网格汇总的数量。GeoPackage 的 tile 关联和影像的有效掩膜不是实施细节,而是让抽检者能回到同一块原始证据的索引。
技术路径:从图块到可核验数量
- 固定影像日期、传感器、GSD、波段、坐标参考系和无效像元规则,保存每块 GeoTIFF 的版本与覆盖范围。
- 将人工点、LiDAR/冠层高度模型衍生点和其他伪标签分别标记为强标注或弱标注,禁止在训练前混为同一种真值。
- 输出逐像元密度图、图块总数和候选点时,分别保存单位、分辨率、阈值和后处理规则。
- 按稀疏孤立树、密林、不同地形和不同传感器分层抽样,分别报告数量误差与位置误差。
- 用 GeoPackage 的
tile回链到影像,对高误差网格做人工复核;同时检查无效掩膜是否被误算为零树。 - 发布到 GIS 前,把模型版本、标签来源、影像许可、训练范围和不适用区域写入图层元数据。
上线前检查清单
- 密度栅格、候选树点和汇总数量是否有不同字段与单位。
- 强标注、弱标注和模型估计是否保留了来源与可信度。
- 图块的传感器、采集时间、GSD、CRS 与有效像元掩膜是否可追溯。
- 是否在密林与孤立树、训练区与新区域、不同传感器之间分层验证。
- 影像许可是否允许当前下载、再分发和使用方式。
风险边界
TinyTrees 的论文结果来自其定义的基准、传感器和实验切分;作者报告的优于若干基线不等于所有林分、季节或城市树种都能达到同样表现。密度图尤其不能直接解释为树冠边界、胸径、健康状态或森林清查的法定结论。阴影、重叠树冠、季节差异、传感器辐射差异和标签时相错配都会改变数字含义。
此外,官方代码明确指出部分影像为 CC BY-NC 4.0 的研究教育用途。工程团队在将训练数据、派生图层或模型服务用于商业项目之前,应分别核对影像、标注和模型的许可,而不是把“代码可获得”理解为全部数据可自由使用。
结论
弱监督树木计数的价值,不在于制造一份看上去无所不知的树位清单,而在于把不完整标注转化为可量化、可回溯的密度证据。TreeMatch 的非平衡匹配和自校正思路提供了一个明确提醒:当树冠本就模糊时,GIS 交付也应诚实区分数量、位置和可信度。