公共卫生、投诉、事故和资源数据经常只能汇总到区县、街区或邮编。为了接入点型空间扫描,常见做法是把每个多边形换成一个质心。但细长行政区、海岸县、被水体切开的邮编,都会在这个步骤中失去真实覆盖范围;后续即使统计显著,候选窗口也可能偏离问题所在。
Sampling for Region-Aggregated Spatial Scan Statistics 提出一个直接的区域采样转换:在每个多边形内取多个点,再把区域计数均分。这不是自动发现事件的承诺,而是让 GIS 异常检测在进入扫描算法前少丢一层空间信息。
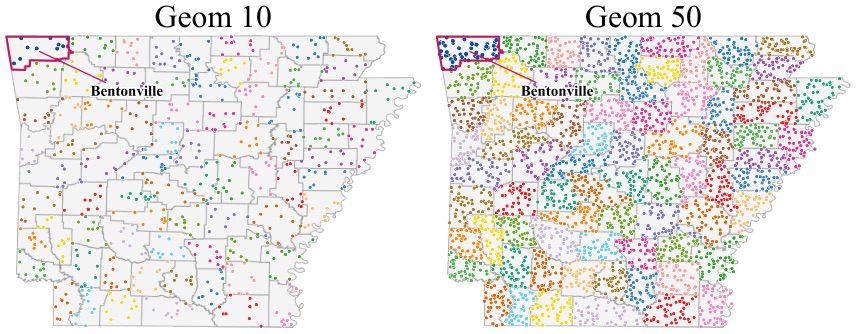 区域采样示意
图:论文以 Arkansas 县为例展示多边形到采样点的转换。
可核查事实:区域数据与点扫描之间有一道转换门
论文 arXiv v1 于 2026 年 7 月 1 日发布;目前 v2 页面标注其已被 ACM SIGSPATIAL 2026 接收,并给出配套代码仓库。它聚焦普查区、邮编和县这类区域汇总计数,而许多高效的空间扫描算法接收的是地理点。
论文指出,SaTScan 等工具对区域数据通常采用单点表示,常见是质心。质心化方便,却会丢失多边形的空间范围并降低统计功效。作者的转换方法是在每个区域几何内均匀采样 20—50 个点,再把该区域的观测计数和基线计数均匀分配到这些点。
实验从 k=1(质心)一直比较到 k=50。论文发现更大的 k 通常提高统计功效,但不一定需要完整的 50 个点;最合适的采样数会受区域几何复杂度和计算约束影响。
评测覆盖 Arkansas、纽约市、Utah、California、Georgia 和美国本土六套地理数据。纽约市案例使用 263 个邮编多边形代表 248 个唯一 ZIP,并将被水面分开的多边形当作独立区域。美国本土案例有 3,711 个县:论文报告在 pq 差值为 0.05 时,Geom 10 的 Point Jaccard distance 可达 0.2。真实案例则使用加州县级 Valley Fever 的 observed/expected 标准化发病比。
核心机制:采样点继承计数,也继承边界假设
区域采样并不是把一份区域记录复制成多份独立观测。论文的做法是将原区域的实测值和基线值均分给每个采样点,使总量保持不变;点只是让扫描窗口能感知区域覆盖,而不改变原始区域的计数总和。
因此,GIS 实施必须保留原多边形 ID、原始计数、基线计数、采样点数 k、随机种子、几何版本和 CRS。否则,扫描输出无法重建,也无法判断候选窗口是数据变化还是采样转换的敏感结果。
GIS 场景:把异常区当作复核队列
县级疾病、街区投诉、邮编犯罪或生态监测指标都可能以区域汇总形式到达。区域采样空间扫描可将这些数据转化为候选异常区,供领域专家查看时序、人口基线、报告延迟、行政边界和现场证据。
地图产品应同时显示候选扫描窗口与输入区域边界,避免把扫描形状误读成权威行政范围或事件影响范围。特别是在低计数和敏感人群数据中,异常检测只提供排序线索,仍需按隐私政策、流行病学或业务规则完成确认。
技术路径:从区域统计到可复现扫描
- 固定原始多边形、计数口径、基线计算、时间窗和 CRS。
- 在每个有效多边形内均匀采样多个点,并将观测与基线计数均分。
- 记录 k、随机种子、区域 ID 与采样点到原区域的映射。
- 对 k=1、10、20、50 做敏感性分析,比较候选窗口、显著性和空间重叠。
- 将通过多组参数稳定出现的窗口送入人工复核,而不是自动发布为事件。
检查清单
- 是否保存了原始多边形和采样点的可回链关系。
- 是否保持区域观测计数与基线计数总量不变。
- 是否记录采样数、随机种子、CRS 和扫描窗口假设。
- 是否完成了不同 k 的敏感性比较。
- 是否把统计候选区与业务确认、隐私复核分开处理。
风险
区域采样会改善几何表达,却不能消除生态谬误、报告偏差、人口基线错误或边界变更带来的风险。窗口形状、扫描模型、计数口径和多重比较都会影响结果。论文的模拟与 Valley Fever 例子不能证明其他地区或业务数据一定能产生可靠预警。
结论
当 GIS 数据以多边形汇总时,质心不是中性的技术细节。区域采样让空间扫描更接近原始几何,但它仍需要完整记录转换参数、稳定性分析和人工确认。把这些证据随候选窗口一起保存,异常检测才会成为可审计的决策辅助。