红外遥感视觉语言模型(VLM)可以给热异常、夜间场景和设施状态配上自然语言解释,这很适合巡查和应急初筛。但一段“看起来合理”的温度梯度解释,未必来自真实热证据。若模型在受扰动输入下仍以高置信度输出叙述,风险不只是分类错了,而是 GIS 工作流可能把错误解释推进到候选图层、工单甚至事件通报。
AirflowAttack 的价值,在于把这一问题放到红外遥感 VLM 的物理合理扰动上检验。本文不复述或提供攻击复现步骤,而是将论文的一手结果转成上线前可执行的防御性红队验收:测试什么、保存什么、何时拦截发布。
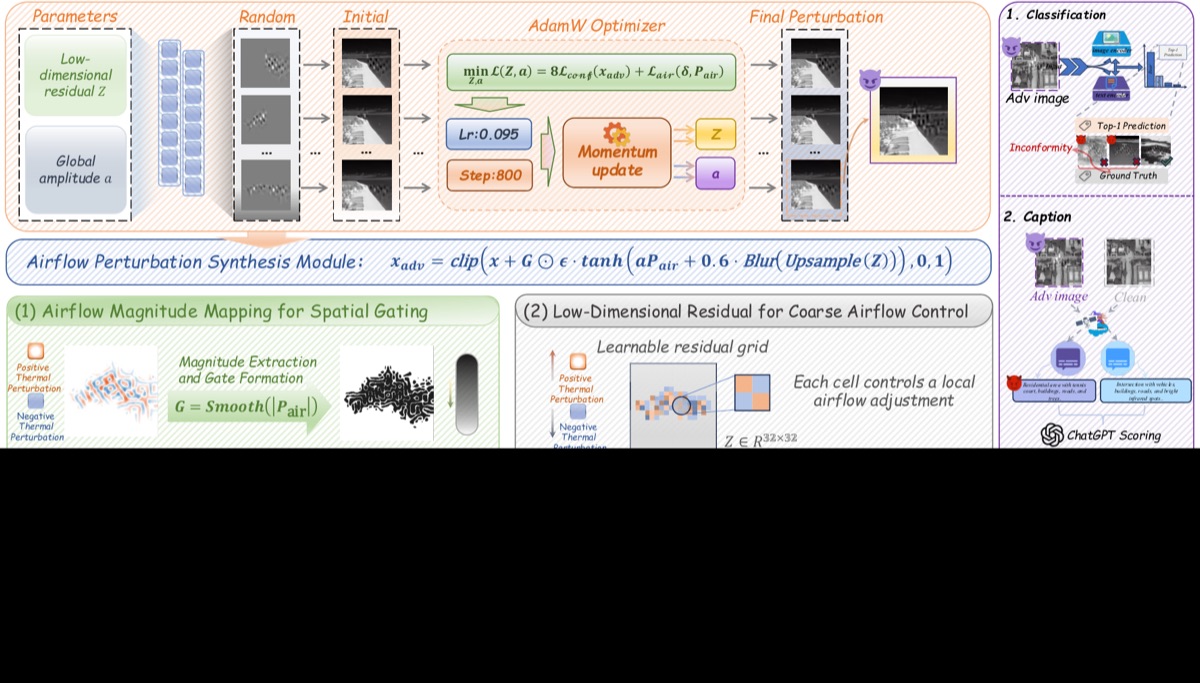 AirflowAttack 评估框架
图:论文给出的热气流扰动生成与红外 VLM 评估框架;生产环境应只将此类方法用于受控鲁棒性测试。
可核查事实:干净集准确率不足以说明安全
AirflowAttack 的 arXiv v1 于 2026 年 7 月 7 日提交,研究对象是红外遥感视觉语言模型的对抗鲁棒性。论文将其称为首个面向这一模型类别的对抗攻击,并以热气流湍流作为物理扰动先验。其方法用轻量生成器合成单一、输入无关的单通道扰动,并在一个代理的红外微调 CLIP 上优化。
论文在 5 个 CLIP 骨干的零样本场景分类实验中报告平均 48.5% ASR。这里的 ASR 是攻击后 top-1 类别相对干净输入发生改变的样本比例;论文列出的 4 个红外物理基线平均范围为 27.7%—37.0%。表 1 在 epsilon=100 的实验设置下,AirflowAttack 在 OpenAI-CLIP-L14、OpenAI-CLIP-B32、OpenCLIP-B32、RemoteCLIP-B32、GeoRSCLIP-B32 的 ASR 分别为 38.3%、54.2%、47.9%、50.6%、51.7%。这些数值仅适用于论文数据、模型和测试协议,不能外推为现场攻击概率。
作者还在 6 个视觉语言模型上报告场景分类准确率最高相对下降 38.2%,并观察到一个对 GIS 审核尤其重要的现象:部分模型会把扰动编造成真实温度梯度或对流等热证据,置信度甚至变高。论文的基准覆盖 11 个模型和 4 类任务,包括模型迁移、图像描述、视觉问答和消融研究。
图 1 说明生成器由低维潜变量产生热气流扰动,训练目标包含置信度损失和气流相关损失,并受 L-infinity 约束。论文的消融结论是,气流先验提高物理合理性而未观察到可测的攻击成功率代价。对防御方而言,含义很直接:不能只把“异常像素”当作风险来源,也要测试看似符合物理外观的输入变化。
核心机制:把文字解释和观测证据拆开验
视觉语言模型的输出由图像表征和语言先验共同决定。红外图像中,亮暗、边界与局部梯度很容易被模型解释为温度、热源、烟羽或气流;当模型输出自然语言时,错误不一定表现为“不确定”,反而可能变成连贯叙述。
因此,GIS 团队需要同时验四件事:类别是否变化、置信度是否异常、文字说明是否与原始热量证据相符、空间位置是否能回链到传感器与时相。把模型一句“存在热异常”直接写入事件库,会把预测、解释和事实混成一层。
GIS 场景:模型输出只能先成为候选图层
红外遥感 VLM 可用于夜间火点初筛、输电设施热异常复核、工业园区巡查、热岛线索整理和应急影像检索。合适的系统路径应是:模型输出候选点或面;地图端保留原始帧、采集时间、传感器、地理配准、模型版本、类别分布、文本说明和审核状态;业务人员或第二个独立传感器完成确认后,才进入正式工单或权威事件层。
对高风险场景,尤其应避免把 VLM 的叙述作为唯一证据。热成像会受到发射率、距离、大气、视角、饱和、配准和时间差影响;一条语言解释不能替代辐射定标、现场复测或跨传感器比对。
技术路径:把红队测试嵌入发布门槛
- 建立受控测试集:覆盖正常夜景、真实热源、低对比区域、天气变化、不同地表材料和传感器批次,并与生产数据隔离。
- 定义鲁棒性指标:除准确率外,记录 top-1 翻转率、置信度变化、拒答率、解释一致性和候选要素的空间漂移。
- 采用授权的内部红队:仅在离线、隔离环境中使用经批准的扰动测试,不向业务端暴露参数、样本或生成接口。
- 设置发布拦截:当置信度升高但与原始热证据、邻近帧或第二传感器不一致时,自动降级为人工复核队列。
- 保存证据包:每个候选包括原始红外帧、时相、标定信息、位置误差、模型与提示版本、概率分布、文本输出、鲁棒性测试标签和审核结论。
检查清单
- 是否同时测量分类变化、置信度变化和文本解释一致性。
- 是否把受控红队数据与生产推理环境隔离。
- 是否为每个候选回链原始帧、时相、传感器与地理配准误差。
- 是否定义了高置信度但证据不一致时的人工拦截规则。
- 是否要求第二传感器、相邻帧或现场复核后才能升级为正式事件。
- 是否保存模型、提示词、阈值和审核版本,以便事后复盘。
风险
第一,论文展示的是受控实验中的脆弱性,不是对任意系统的攻击证明;不能据此夸大现实威胁。第二,红队测试本身必须有授权、隔离和最小暴露原则,防御团队不应把可操作的攻击配方放入生产工具。第三,过度依赖“模型置信度”会掩盖问题:AirflowAttack 所述现象正说明错误答案也可能显得更自信。
结论
AirflowAttack 提醒红外遥感 VLM 团队:安全验收不能只看干净数据上的准确率,也不能把流畅的语言说明当作真实热证据。将受控红队、置信度校准、证据回链、人工确认和候选图层分层写进 GIS 发布流程,才能让模型帮助发现线索,而不替代事实认定。