野火模型往往在算法之前失效:火场边界来自一套资料,气象来自另一套时间轴,地形和燃料又落在不同网格。即使模型没有变,下一次重新取数也可能得到不同输入。对 GIS 团队,最先需要固定的不是网络结构,而是一份能按事件重放的数据合同。
FireDataForge 于 2026 年 6 月 19 日提交 arXiv。论文提出开源 Python 框架,将多源野火数据的检索、协调和输出组织为事件驱动流程。它的入口是 MTBS Event ID:一个 ID 对应一场火灾,能从 MTBS Data Explorer 以火名、年份和州查询。这让范围、时段和数据准备不再依赖一次性的手工选择。
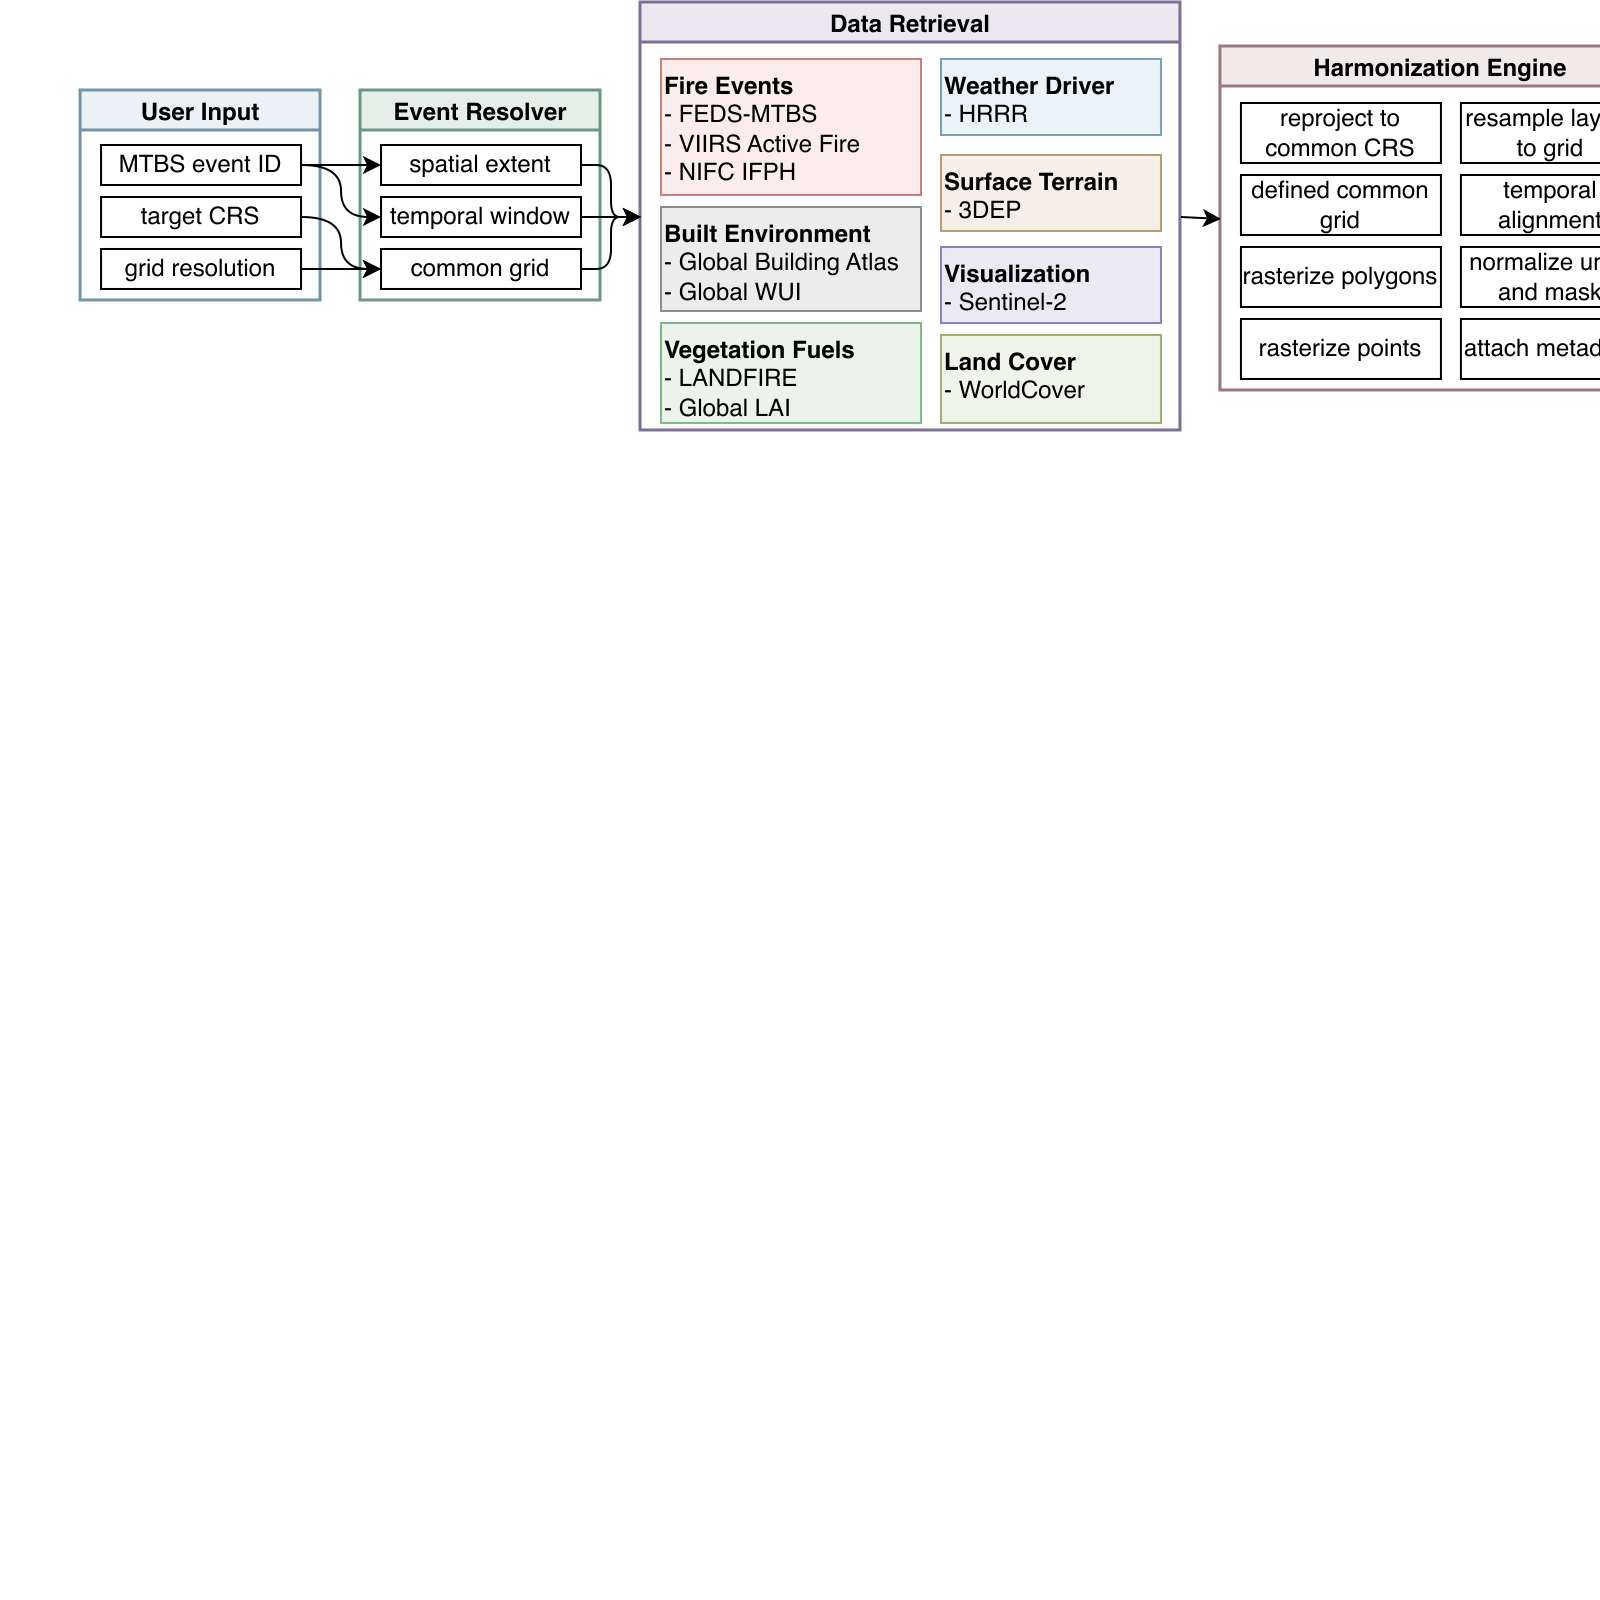 FireDataForge 多源野火数据流程
图:FireDataForge 的事件驱动检索、协调与输出流程,来源:论文 HTML 全文。
可核查事实
- 框架自动处理 11 类野火相关来源,覆盖火行为、天气、土地覆盖、植被、高程、建成环境、WUI、火灾历史与卫星影像。
- 给定 MTBS Event ID 后,系统检索数据,重投影和重采样到共同网格,并输出带元数据的 NumPy 数组。
- 用户可指定目标 CRS、分辨率和事件 ID;系统会解析火灾时段和范围,也允许自定义。
- 不同来源由类别组件处理;可并行的检索并行执行,受限来源顺序处理。
- 除 HRRR 外,论文所述图层进入目标网格;HRRR 保留约 500 米、同范围同投影网格,因为上采样不会增加信息。
- 作者将输出用于火行为模拟、教育可视化、机器学习和 AI 辅助历史火灾分析。
- 论文明确将此按事件生成方式与固定区域、固定时期、固定网格的数据集区分。
核心机制:用事件 ID 固定输入的语义
FireDataForge 的关键不是把所有图层强行拼成一个大栅格。它先用事件 ID 确定火灾的范围和时间窗,再按数据类别检索、按目标 CRS 与分辨率处理,并保留元数据。这样一次模型运行可以追溯到“哪场火、哪些来源、何时下载、如何重采样”。
空间对齐也不能只看像元大小。论文说明,HRRR 被保留在约 500 米网格,而不是假装变成更细分辨率;因为上采样不增加天气信息。这正是 GIS 入库应保留每层原始分辨率、重采样方法和有效时间的原因。
GIS 场景:把模型输入发布为可审计数据产品
在火灾模拟、历史复盘或训练样本准备前,创建一张事件清单:MTBS Event ID、边界版本、起止时间、目标 CRS、网格、每个来源的下载时间和许可。输出数组之外,应同时保存范围掩膜、空值比例、重采样规则、时间插值规则与软件版本。缺少任一项,都不应把该批输入标为可复跑。
将输入分成静态层和动态层。高程、建成环境和部分土地覆盖属于静态背景;气象、火前火后影像、火行为记录则必须带明确时相。若动态层与火灾时段不重合,应该保留缺口或降级标记,不能用最近的一景无声替换。
技术路径
- 用权威事件 ID 生成范围与时间窗,保存查询与边界版本。
- 为每个来源登记原始 CRS、分辨率、时间粒度、下载时间与许可。
- 明确每个变量的重投影、重采样和时间对齐方法;连续变量与类别变量不能共用默认算法。
- 输出共同网格前检查空间覆盖、缺失率、值域与单位,并记录失败来源。
- 对 HRRR 等较粗数据保留原生有效分辨率标识,禁止把插值结果误写为新增观测。
- 将数组、元数据清单、运行配置和质量报告作为一个版本交付给模型与 GIS 客户端。
风险边界
论文描述的是研究型开源框架及其历史火灾批处理,不是实时应急服务承诺。各来源的可用性、时效、许可和覆盖会变化;事件 ID 也不能替代现场边界确认。共同网格方便分析,却不能消除原始观测的尺度差异和缺测。高风险派单、疏散或火情通报仍要以权威应急数据和人工核验为准。
结论
野火 GeoAI 的可靠性先取决于输入能否重放,再取决于模型是否复杂。FireDataForge 展示了事件 ID、空间时间对齐和带元数据输出如何构成最小数据合同。把这份合同与模型版本一同发布,才能让结果接受复算、质疑和改进。