一张街景图、一段自然语言提示,模型随即给出国家、城市甚至一组坐标。这样的输出很容易被当作空间事实写回 GIS。但一个看似合理的地点答案,可能来自地标、路牌、语言、拍摄分布,或者训练语料中的偶然关联。真正需要审计的不是模型是否说对过几次,而是它的内部表示是否稳定携带了可复核的地理线索,以及这些线索在哪些图像和地区会失效。
《Textual Supervision Enhances Geospatial Representations in Vision-Language Models》 于 2026 年 6 月 5 日提交 arXiv,页面标注为 ICML 2026 接收。研究比较了视觉模型、视觉语言模型与多模态基础模型,例子包括 ViT、CLIP、LLaVA、Qwen 和 Gemma。作者把“地理表征”限定为模型内层中、与地球上物理位置相关并可服务下游任务的潜在特征;这一定义很重要:它讨论的是可从表示中提取的信号,不等同于模型获得了可直接采信的坐标能力。
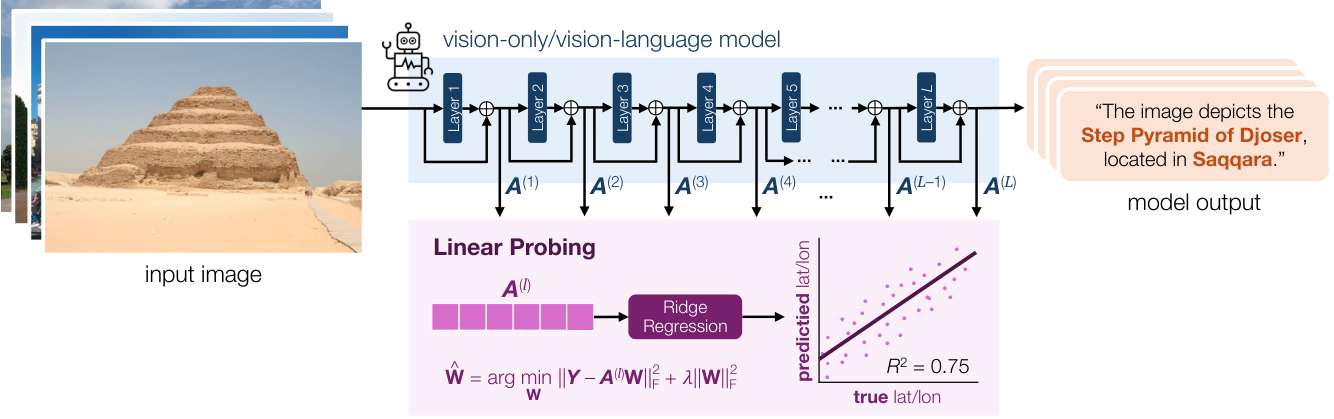 分层线性探针如何读取模型中的地点线索
图:论文用各层摘要表示训练岭回归探针,预测纬度和经度;来源:论文 HTML 全文。
可核查事实
- 论文在视觉模型、视觉语言模型和多模态基础模型之间比较地点相关表征,涉及 ViT、CLIP、LLaVA、Qwen 与 Gemma 等模型。
- 评测使用 YFCC100M 与 Google Landmarks 图像,并按人物、地标、日常物体等图像簇的可定位程度分析。
- Google Landmarks 的数据说明包含超过 500 万张全球地标与旅游地点照片;论文实验采用 58 万张图像子集。
- 为减轻样本偏向欧洲和北美大城市的问题,作者按行政区构造不重叠 geocell;每个来源选取 5000 张图、每个 geocell 至多 5 张。
- 探针从每一层的 CLS token 或最后 token 表示出发,用岭回归预测以度为单位的纬度、经度,并以 R² 评价。
- 作者报告文本图像联合训练模型在地标和街景簇上最高 R² 可达 0.8;较大模型平均 R² 超过 0.4,多数视觉模型的平均值低于 0.3。
- 街道、建筑、地标通常较容易定位,普通物体图像提供的地点线索较少;符号和文字簇在 VLM 中的可定位性更明显。
- 在选定模型的试验中,约 40% 的特征维度已可恢复接近最高 R²;Qwen2.5-VL 变体使用排名前 10% 特征仍保留约 90% 的最佳预测表现。
核心机制:先测隐藏表示,再谈地点能力
论文没有把模型直接输出的城市名当作证据。它取视觉模型的 CLS token 或多模态模型的最后 token 表示,在每一层单独训练一个岭回归器,以图像已知的纬度和经度为目标,再用 R² 判断这层表示中是否存在可线性读出的地点信息。这个设计可以回答一个更实用的问题:位置线索是在模型的哪一层出现、面对何种图像更稳定、语言参与训练后有没有变化。
对 GIS 工程而言,线性探针不是生产算法,而是一种验收工具。若要把图像嵌入用于相似地点检索、街景核验或候选区域排序,可抽取目标模型的嵌入,在有独立坐标标签的留出集上复现类似检查。记录模型版本、输入提示、所取层、训练范围、地域分层和误差指标,才能区分“模型带有地点线索”和“某次演示正好猜对”。
文本不是附加装饰,它会改变可用的空间线索
论文报告,文本与图像联合训练的模型在地标和街景簇上最高 R² 达到 0.8;较大模型的平均 R² 超过 0.4,而多数视觉模型平均低于 0.3。作者还观察到:街道、建筑和知名地标通常比普通物体更容易定位;符号与文字簇在 VLM 中呈现出视觉模型没有的可定位性。
这解释了一个常见现象:对同一张图,加入“请判断该图的国家或纬度经度”一类任务提示后,模型可能更愿意调用与地理有关的表征。但这并不证明文本让模型看见了图中不存在的地理事实。路牌文字、语言、品牌、建筑风格和被训练语料关联的描述都可能成为快捷线索。在有多语言路牌或隐私敏感场景时,团队必须把这些线索的来源和合规性写入模型卡。
GIS 场景:用三层验收约束地点推断
第一层是图像类型。 按街道、建筑、地标、自然景观、近景物体、文本密度等维度分桶。论文的结果已经显示,不同簇的可定位性差异显著;不能用地标测试集的好结果宣称仓储货物、农田近景或灾害现场同样可靠。
第二层是地域覆盖。 论文明确指出原始分布偏向欧洲和北美大城市,并以 geocell 抽样缓解。业务评测也应按国家、省市、城乡、语言和采集设备切片,保留每一切片的样本数、定位误差和拒答率。若目标区域没有独立标签,应将模型输出留在候选队列,不能作为自动写入的地理编码。
第三层是输出用途。 对检索排序,可把地点表征作为一个特征,并展示原始图像、相似样本与置信区间;对人工核验,可提示分析师去检查路牌、建筑或地图上下文;对资产定位、执法或应急派单,应要求权威底图、现场记录或第二数据源确认。模型生成的坐标可以触发复核,不能取代复核。
技术路径:建立可复跑的地点线索审计
- 固定模型、权重、推理参数和文本提示,保存每条样本的输入版本。
- 将带可靠坐标的留出样本按图像簇与地域切片,避免同一地标或相邻连拍跨入训练和测试。
- 先测业务输出的距离误差、国家/区域命中率与拒答率,再按需对嵌入做分层线性探针。
- 记录每层或每个嵌入版本的指标,观察文字提示、图片分辨率和遮挡是否改变结果。
- 对高置信结果保留可复核证据:原图、提示、相似样本、底图叠加和人工结论。
- 当一个地区或图像簇低于业务阈值时,返回“需核验”而不是伪精确坐标。
风险边界
论文的 R² 来自特定数据、模型和探针设定,不能转化为任何地区的定位精度承诺。Google Landmarks 中的知名地点天然比普通物体更有辨识度;即使 geocell 抽样缓解了分布不均,也不能消除训练语料、语言和拍摄行为带来的偏差。模型内存在可读的经纬度线索,也不说明这些线索对每张图都正确、稳定或适合自动化决策。
结论
这项研究给 GIS 的价值,不是让系统更大胆地相信模型坐标,而是提供一套把“地点直觉”变成可测量对象的方法。文本监督可能让模型更善于利用空间线索,但上线前仍要按图像类型、地域覆盖和业务用途分别验证。把每次地点推断保存为可回查的候选证据,而不是直接改写要素位置,才能让多模态 GeoAI 真正进入可治理的工作流。