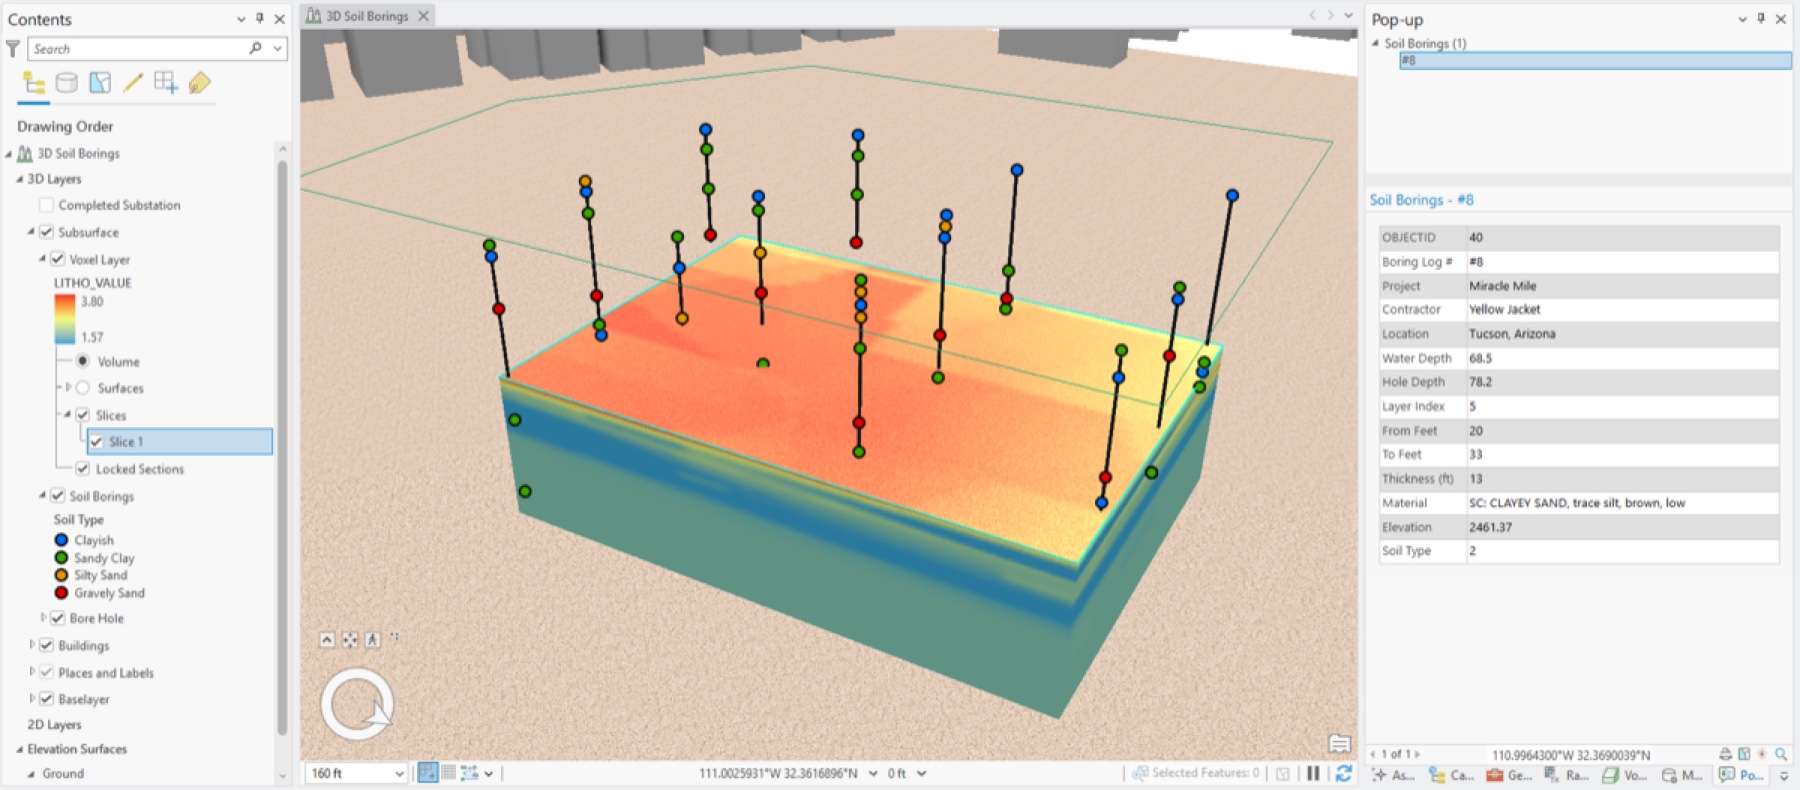
 ArcGIS Pro 中由 boring log PDF 自动生成的钻孔点位和分层剖面弹窗
土工钻孔日志很像 GIS 团队最不愿面对的一类资料:它有明确位置,也有大量关键属性,却常常躺在 PDF、扫描件和项目文件夹里。工程师真正需要的不是“某份报告在哪里”,而是“某个区域的黏土层从哪里开始变薄”“哪些钻孔较早触底”“同一条道路沿线的地下条件是否连续”。这些问题天然带有空间含义,但如果资料仍停留在 PDF,地图系统就只能等人工录入之后再发挥作用。
Esri 在 2026 年 8 月 28 日发布的文章《From documents to a living map: Transform boring logs with AI in ArcGIS Pro》给了一个很具体的答案:用 ArcGIS Pro 的 GeoAI 文本分析能力,把 boring log PDF 交给自定义 AI 模型读取,再生成钻孔点位和逐层属性。它不是把 AI 放在地图旁边做问答,而是让 AI 进入地理处理链路,把非结构化工程文档转成可查询、可制图、可复核的数据层。
这个变化解决的是录入瓶颈
钻孔日志的信息密度很高。一个项目可能只有几十份,一个长期工程计划可能有成百上千份。每份日志都记录深度、土层分类、标贯击数、取芯率、现场描述、坐标或位置说明等内容。传统做法是工程人员逐份打开、阅读、摘录,再把结果录入表格或 GIS 图层。
这一步慢,而且容易产生两个问题。第一,人工录入容易丢字段、误读缩写、错放深度单位。第二,录入完成前,GIS 系统看不到这些垂向信息,只能把 PDF 当附件管理。Esri 示例中的输出更接近 GIS 用户真正想要的状态:地图上每个点代表一个 borehole sample,弹窗里带有 layer-by-layer profile、classification codes、depths、field notes 和 refusal 等信息,而且这些记录不是人工逐项键入。
这意味着 AI 的价值不只是“读文档”,而是把文档里的空间信号释放出来。钻孔点位可以参与缓冲区分析、剖面比对、线路选线、风险区划,也可以和地形、地质、管线、地块、工程分段叠加。
核心不是聊天模型,而是 .dlpk 包装
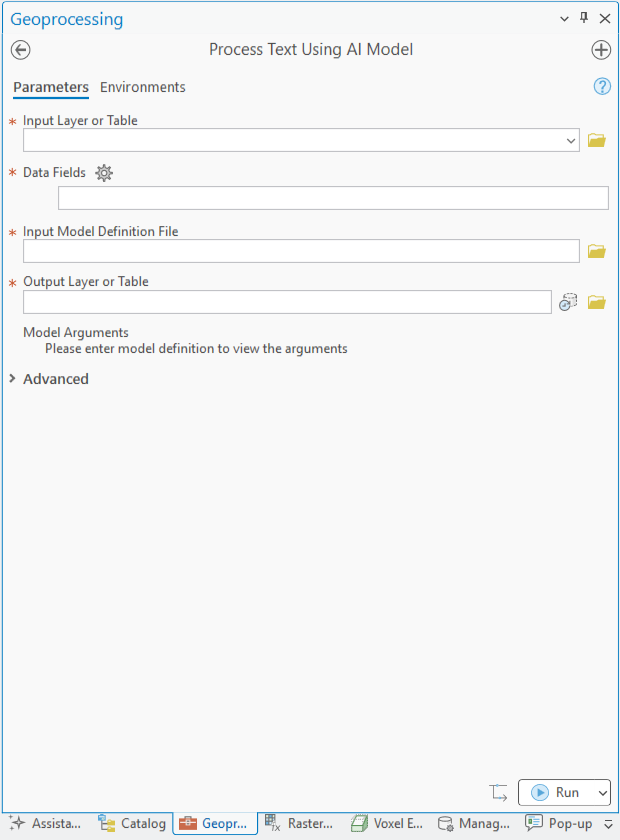 Process Text Using AI Model 的 Model Arguments 配置界面
这条链路的中心工具是 ArcGIS Pro GeoAI toolbox 下的 Process Text Using AI Model。Esri 文档说明,这个工具可以处理要素类、表、文件夹等输入中的文本材料,输入模型可以是 .emd 或 .dlpk,也可以使用第三方语言模型。
这次示例的关键在于自定义深度学习包。文章给出的 .emd 思路很清楚:用 InferenceFunction 指向 SoilBoringExtractor.py,用 ModelType 标明这是 ProcessText 类型。也就是说,GIS 工具负责把输入、参数、输出纳入地理处理框架,Python 推理函数负责调用外部模型、解析结果并返回结构化数据。
公开的 CodeHeistPy/soil-boring-extractor 仓库进一步把实现细节摊开。README 说明,这个包面向 ArcGIS Pro 的 Process Text Using AI Model,用于读取 soil boring log PDF,把文件发送给用户选择的 LLM provider,并输出结构化表或要素类,另带 GeoJSON export。它支持 Anthropic、OpenAI、Google Gemini 和 Azure OpenAI,最终使用哪个供应商由运行工具的人在 Model Arguments 里配置。
这点对企业 GIS 很重要。很多团队不希望把模型、提示词、输出字段和 API key 写死在一次性脚本里。仓库把 settings.json、extraction_prompt.md、output_fields.json 外置,让解决方案负责人可以改默认供应商、抽取提示和输出字段;最终用户则只需要在工具界面里填 provider、API key、model、fallback model、Azure endpoint、Pages Per Chunk 等运行参数。
GIS 团队可以怎么接入
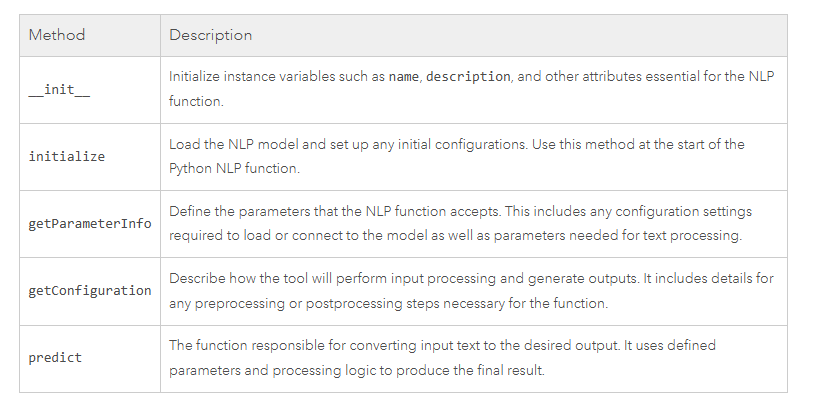 SoilBoringExtractor .dlpk 的推理函数生命周期示意
一个可落地的接入方式可以分成五步。
第一步,先把场景收窄。不要一开始就要求 AI 读懂所有工程报告。更稳妥的是选择一种版式相对稳定、字段价值明确的文档,例如某类土工钻孔日志、管线探测记录、巡检报告或施工照片说明。
第二步,定义输出字段。对 boring log 来说,至少要明确钻孔编号、项目名称、位置、坐标、深度起止、土层分类、标贯信息、取芯率、现场备注和异常标记。字段越接近后续 GIS 分析,越容易验收。
第三步,把模型调用封装进标准工具。ArcGIS 的第三方语言模型文档说明,自定义 NLP function 通常包含 __init__、initialize、getParameterInfo、getConfiguration、predict 等方法。这样做的好处是,模型不是孤立脚本,而是能够被 ArcGIS Pro 的工具参数、输出图层和地理处理流程管理。
第四步,建立人工复核层。AI 抽取结果不能直接进入工程结论。更合理的做法是在输出图层里保留原 PDF 来源、页码或文件名、抽取置信线索、需人工复核标记,并让工程人员抽查字段。对坐标缺失、深度异常、分类不明、模型返回不完整的记录,应进入待复核队列。
第五步,再考虑自动化。Esri 文章提出,桌面工具只是概念验证,工作流可以进一步发布成 ArcGIS Enterprise geoprocessing service。发布为服务后,新日志进入目录时,可以按计划或事件触发处理,抽取结果再写回要素层、质量队列或项目数据库。
为什么这比通用 OCR 更像 GeoAI
通用 OCR 只解决“图片或 PDF 变成文字”。这里真正难的是后半段:把文字变成空间数据结构,并让它进入 GIS 工作流。
Boring log 的信息有水平位置,也有垂向结构。一个钻孔不是一个普通点,而是一个带地下分层剖面的空间对象。如果 AI 只返回一段总结,GIS 团队仍然无法做剖面对比、线路风险判断或工程分区。只有当结果变成字段、要素、层级记录和可追溯附件,才算进入 GIS 生产。
这也是 .dlpk 的意义。它把模型调用和 ArcGIS 工具体系连接起来:输入来自文件夹、表或要素类;输出回到表或 feature class;后续可以发布 hosted feature layer、触发审核、写入已有数据集,或者作为企业地理处理服务的一环。
落地风险要提前写进方案
第一类风险是资料合规。Esri 文档明确提醒,第三方语言模型 .dlpk 可能包含可执行代码,只应运行可信来源;如果使用 web-hosted LLM,被处理的数据会发送给对应供应商。工程资料、地下空间资料、甲方报告和敏感项目文件是否允许外发,必须在试点前确认。
第二类风险是 PDF 版式差异。不同勘察单位的日志模板、缩写方式、坐标字段和页码组织方式可能不同。soil-boring-extractor 的兼容性文档也提到,大型或多钻孔 PDF 可能导致输出截断。仓库 2026 年 7 月 27 日的 1.3.0 变更增加了 Pages Per Chunk,用来把大 PDF 拆成页块处理,再合并抽取记录。这说明生产部署不能只测一两份样例文件。
第三类风险是 ArcGIS Pro 版本。该仓库文档把 ArcGIS Pro 3.6 列为已验证版本,并指出 3.5.6 的工具 UI 参数验证存在已知问题。对企业交付来说,版本矩阵必须写清楚:哪个 Pro 版本可用,哪些需要 Notebook 路径绕过,哪些配置需要重测。
第四类风险是结果责任。AI 负责抽取和初步结构化,不负责替工程师做最终地质判断。正式流程里需要保留原文件、抽取时间、模型供应商、模型版本、提示词版本、输出字段版本和人工复核记录。
下周可以做一个小试点
如果一个 GIS 团队想验证这条路线,不需要先做大平台。可以从 20 到 50 份同一类型 boring log PDF 开始,按下面的方式验收:
-
先人工定义标准字段表,确认哪些字段必须进入图层,哪些只作为备注保留。
-
用 Process Text Using AI Model 跑一版抽取,输出到临时 feature class 或表。
-
随机抽查若干份 PDF,对比钻孔编号、坐标、深度区间、土层分类、SPT、refusal 等关键字段。
-
把抽取错误分成三类:提示词可修、输出字段可修、原文质量或版式导致不可自动修。
-
如果错误集中在提示词和字段定义,就调整
extraction_prompt.md和output_fields.json;如果错误来自扫描质量或版式跨度,就先限制适用文档范围。 -
通过后再把结果图层接入项目地图、审查看板或 ArcGIS Enterprise 服务,避免直接把未复核结果放进正式库。
结论
这次 ArcGIS Pro boring log workflow 的重点,不在于“AI 又能读 PDF 了”,而在于它把工程文档、第三方 LLM、自定义 .dlpk、GeoAI 工具箱和要素图层连成了一条可部署链路。
对 GIS 团队来说,最值得借鉴的是这个方向:先找到一个高价值、结构稳定、人工录入成本高的资料类型,再把抽取逻辑包装成标准地理处理工具。这样 AI 不只是回答问题,而是参与数据生产;地图也不只是展示结果,而是承接复核、分析和后续业务动作。
资料来源:Esri ArcGIS Blog,ArcGIS Pro Process Text Using AI Model 文档,ArcGIS 第三方语言模型开发文档,CodeHeistPy/soil-boring-extractor 仓库。