遥感基础模型这两年不缺名字,也不缺论文。真正让 GIS 团队头疼的是另一个问题:模型输出怎样进入现有的 QGIS、GDAL、rasterio、WebGIS、专题图生产和业务核查流程?如果每一次试验都停在 notebook,价值很难传到自然资源、农业、应急、城市治理或企业 GIS 团队。
2026 年 8 月中旬出现了两个值得放在一起看的信号。AllenAI 在 Hugging Face 发布了 OlmoEarth Studio 的自定义 embedding 导出能力;两天后,TorchGeo 0.10.0 发布,重点加入完整时序支持、sampler 重构、更多数据集与任务模块。这两件事放在一起看,说明遥感 AI 正从“端到端模型演示”转向更可交换、更工程化的 GIS 工作流。
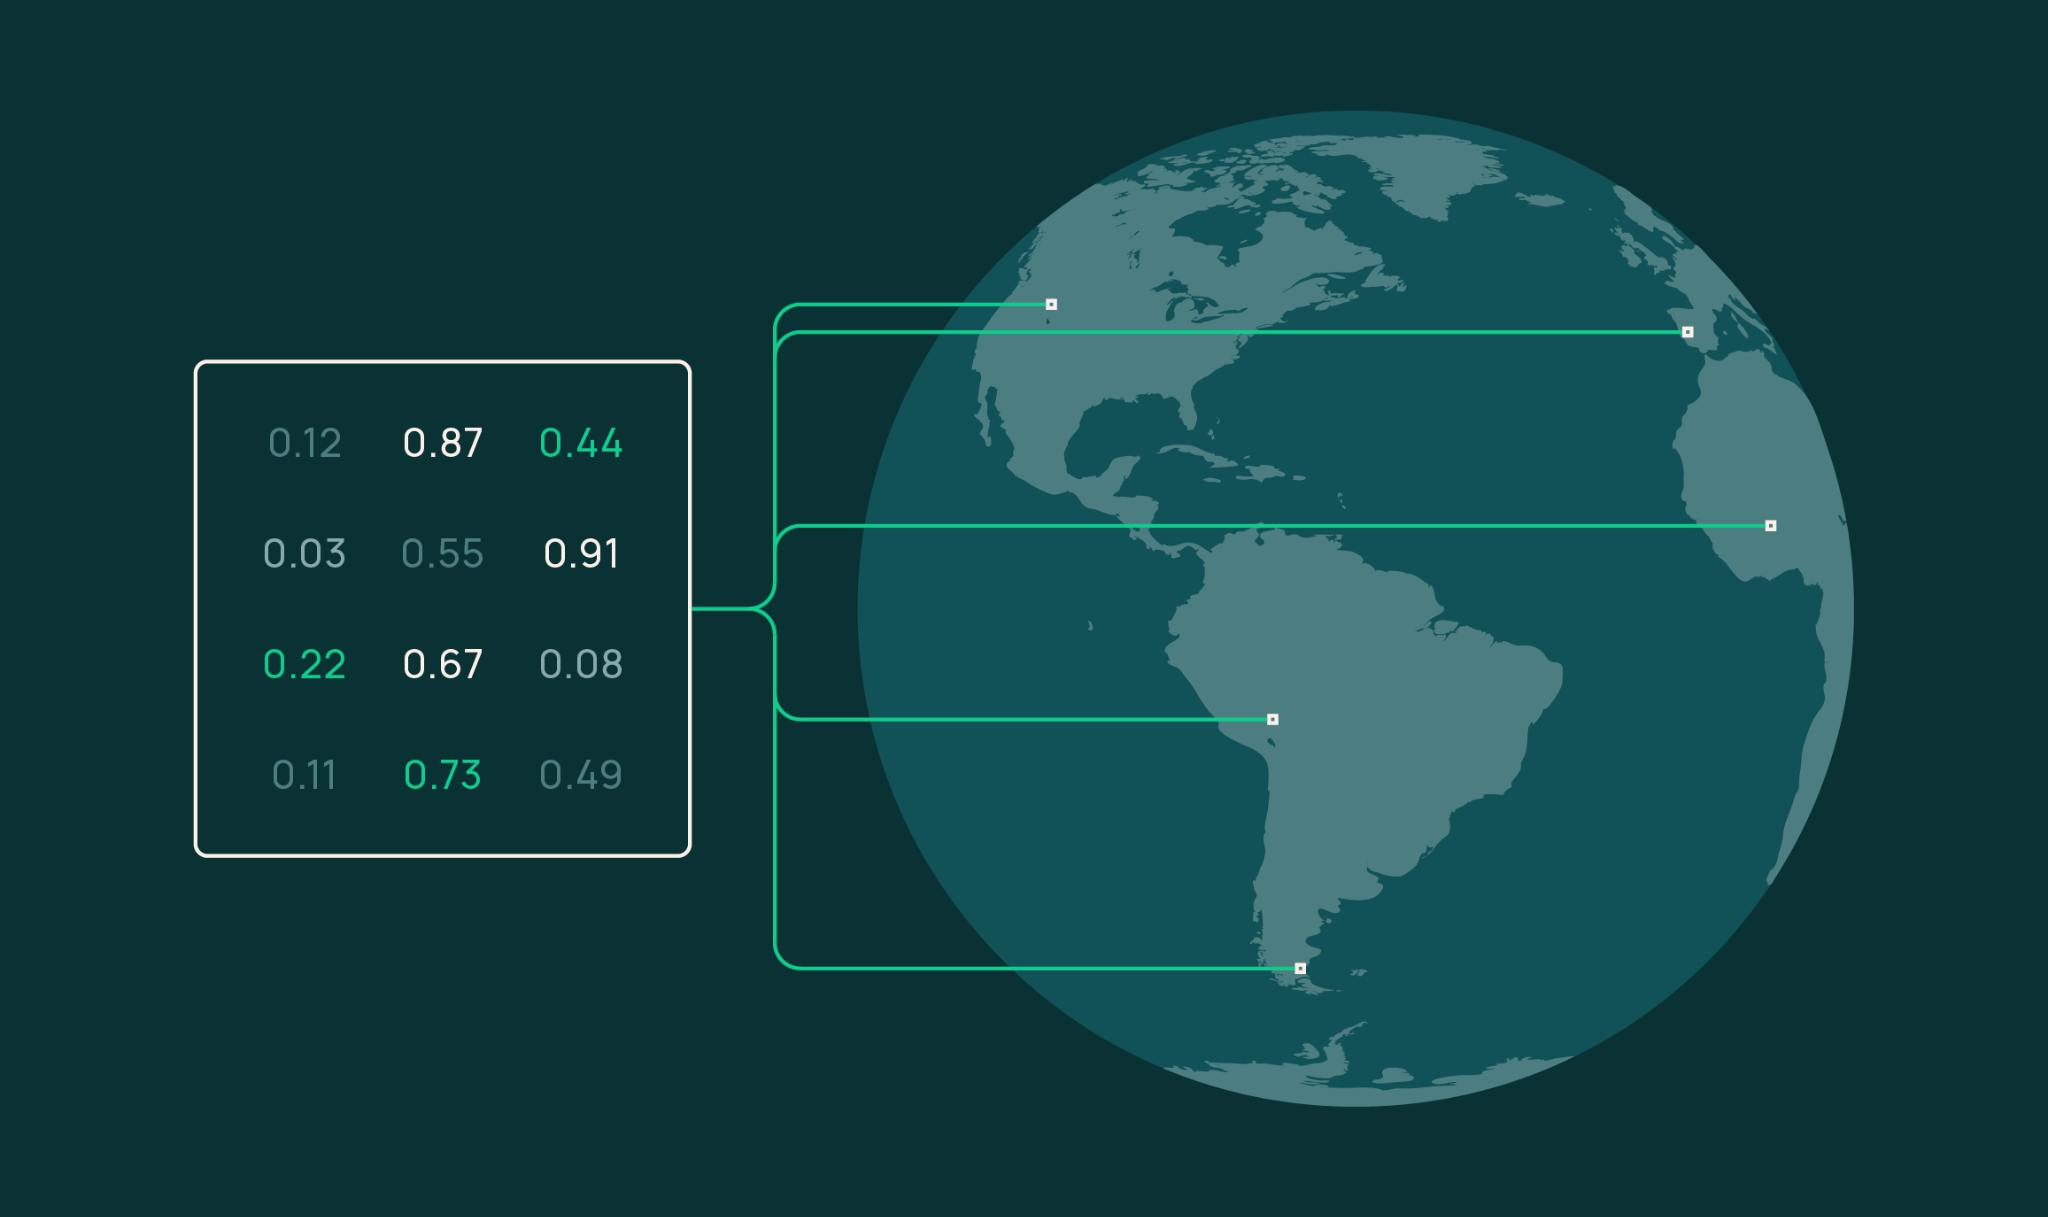 OlmoEarth embedding 的全局聚类可视化
可核验事实
为了避免把这个题目写成概念判断,先把今天采用的事实边界列清楚:
- Hugging Face / AllenAI 在 2026 年 8 月 12 日发布 OlmoEarth embeddings 文章,介绍 OlmoEarth Studio 的自定义 embedding 导出能力。
- 该能力允许用户配置研究区、时间范围、编码器变体、空间分辨率和影像来源。
- Studio 参数覆盖 1 到 12 个按月时间段,编码器包括 Nano、Tiny、Base 三种变体。
- 文章列出的空间分辨率包括 10 米、20 米、40 米、80 米。
- 可选影像来源包括 Sentinel-2 L2A、Sentinel-1 RTC,或二者组合。
- OlmoEarth Studio 输出的 embedding 可导出为 Cloud-Optimized GeoTIFF,每个 embedding 维度对应一个波段。
- 文章提供了相似性搜索、少样本分割、变化检测、PCA 可视化四类示例,并提供 GitHub 教程和 Colab notebook。
- 文章明确提醒,持续云覆盖、大气伪影或合成期缺失观测会影响 embedding 质量。
- TorchGeo 0.10.0 于 2026 年 8 月 14 日发布,release notes 称该版本包含 220 个 PR 和 29 位贡献者。
- TorchGeo 0.10.0 增加完整时序支持,并将 sampler 体系重构为空间 sampler 与时间 sampler 的组合方式。
- TorchGeo README 将项目定位为 PyTorch 的 geospatial 领域库,提供 datasets、samplers、transforms 和 pre-trained models。
- GDAL 官方文档列出 COG、STAC Items、GeoParquet、PostGIS、PMTiles、Google Earth Engine 等与现代地理空间数据栈相关的格式或驱动。
这些事实共同指向一个实践判断:遥感基础模型要进入 GIS 团队,不只要有模型能力,还要把输出变成可读取、可复核、可入库、可再次训练的空间数据资产。
这个能力能解决什么问题
OlmoEarth 的新能力不是直接给一张“分类图”,而是把地球观测影像转换成 embedding,也就是每个位置的一组特征向量。对 GIS 团队来说,这更像一个可复用的中间层:同一块区域可以先生成特征,再根据不同业务目标做相似性搜索、少样本分割、变化检测或无监督探索。
这点很重要。传统遥感项目往往要先确定分类体系、收集样本、训练模型,然后才能出图。一旦业务口径变化,例如从“建设用地识别”改成“疑似新增硬化面巡查”,流程就要重新组织。Embedding 的价值在于,它把前半段“理解影像结构”的工作提前做成一个可交换资产,后半段可以用少量样本或简单模型快速试错。
AllenAI 的示例很具体:用户可以在 Studio 中选择研究区、时间范围、编码器变体、空间分辨率和影像来源,然后得到 Cloud-Optimized GeoTIFF。文章还展示了相似性搜索、少样本分割、变化检测和 PCA 可视化四类用法。这些不是只能在网页里看的结果,而是可以被 QGIS、GDAL、rasterio 或脚本继续读取的地理栅格数据。
为什么 COG 是关键
很多遥感 AI 演示难落地,不是模型不够强,而是交付物和 GIS 生产环境脱节。业务系统需要坐标、分辨率、nodata、波段、元数据、访问权限和可追溯记录;模型团队常交付的是数组、pickle、临时 notebook 或截图。
OlmoEarth embedding 选择导出为 COG,这一点对 GIS 工程化很友好。COG 仍然是 GeoTIFF,但更适合云端按需读取。一个 embedding COG 可以有多个波段,每个波段对应一个向量维度。GIS 团队不必把它理解成普通 RGB 影像,而应把它看成“每个像元的一组可计算特征”。
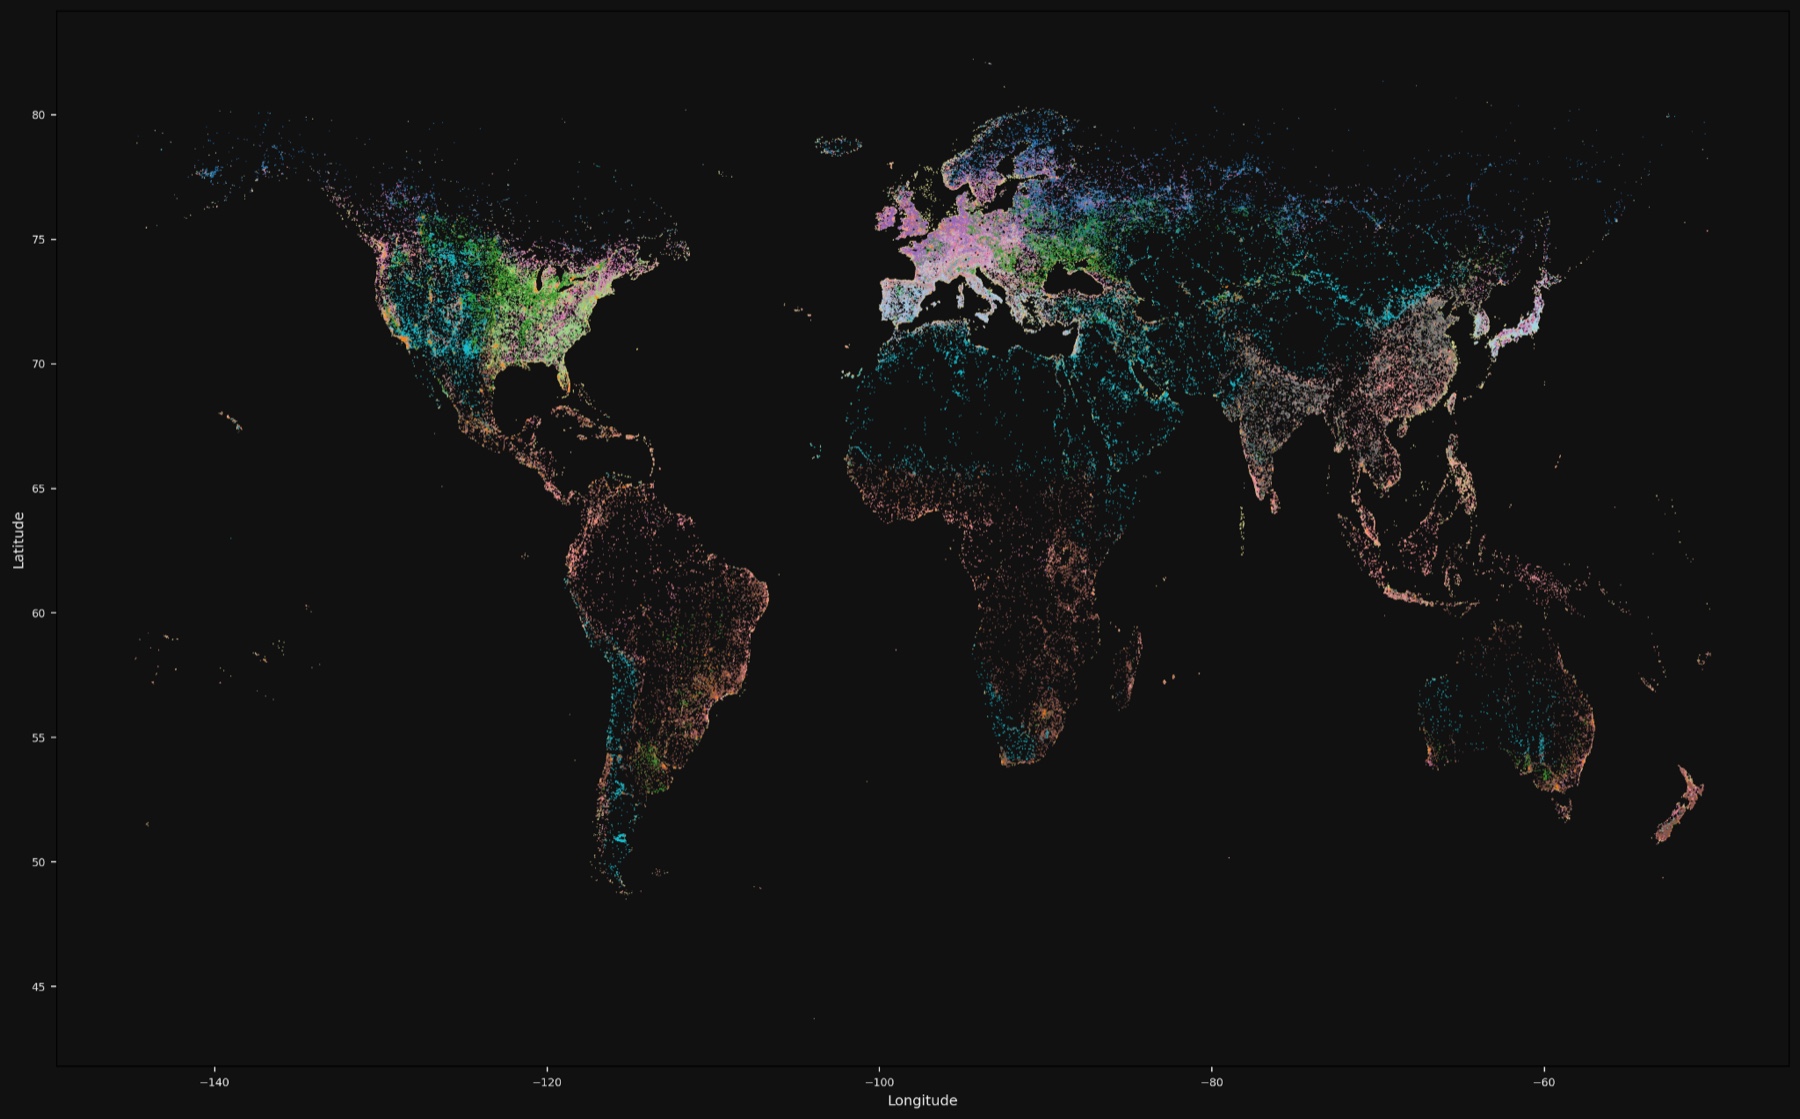 同一 OlmoEarth embedding raster 的不同可视化方式
GDAL 文档也说明,现代地理空间数据栈已经同时覆盖 COG、STAC、GeoParquet、PostGIS、PMTiles、Google Earth Engine 等格式或驱动。换句话说,遥感 AI 输出如果遵守这些通用数据接口,就更容易进入现有数据湖、专题制图、在线地图和空间数据库。
TorchGeo 0.10 补上训练与评估这半条链路
如果 OlmoEarth embedding 更像“可交换的特征层”,TorchGeo 0.10.0 则更像“训练、采样、评估和迁移的工程脚手架”。TorchGeo 官方 release notes 显示,0.10.0 于 2026 年 8 月 14 日发布,包含 220 个 PR、29 位贡献者,是项目历史上规模最大的发布之一。
这一版最值得 GIS 与遥感团队关注的是完整时序支持。遥感业务天然带时间维度:农作物长势、洪涝过程、森林扰动、城市扩张、灾害前后变化,都不是单张影像能稳定回答的问题。TorchGeo 0.10.0 新增或覆盖了多类时序、时空分割、变化检测和时空回归任务,并重构 sampler,把过去偏文件式的采样方式转向空间 sampler 与时间 sampler 的组合。
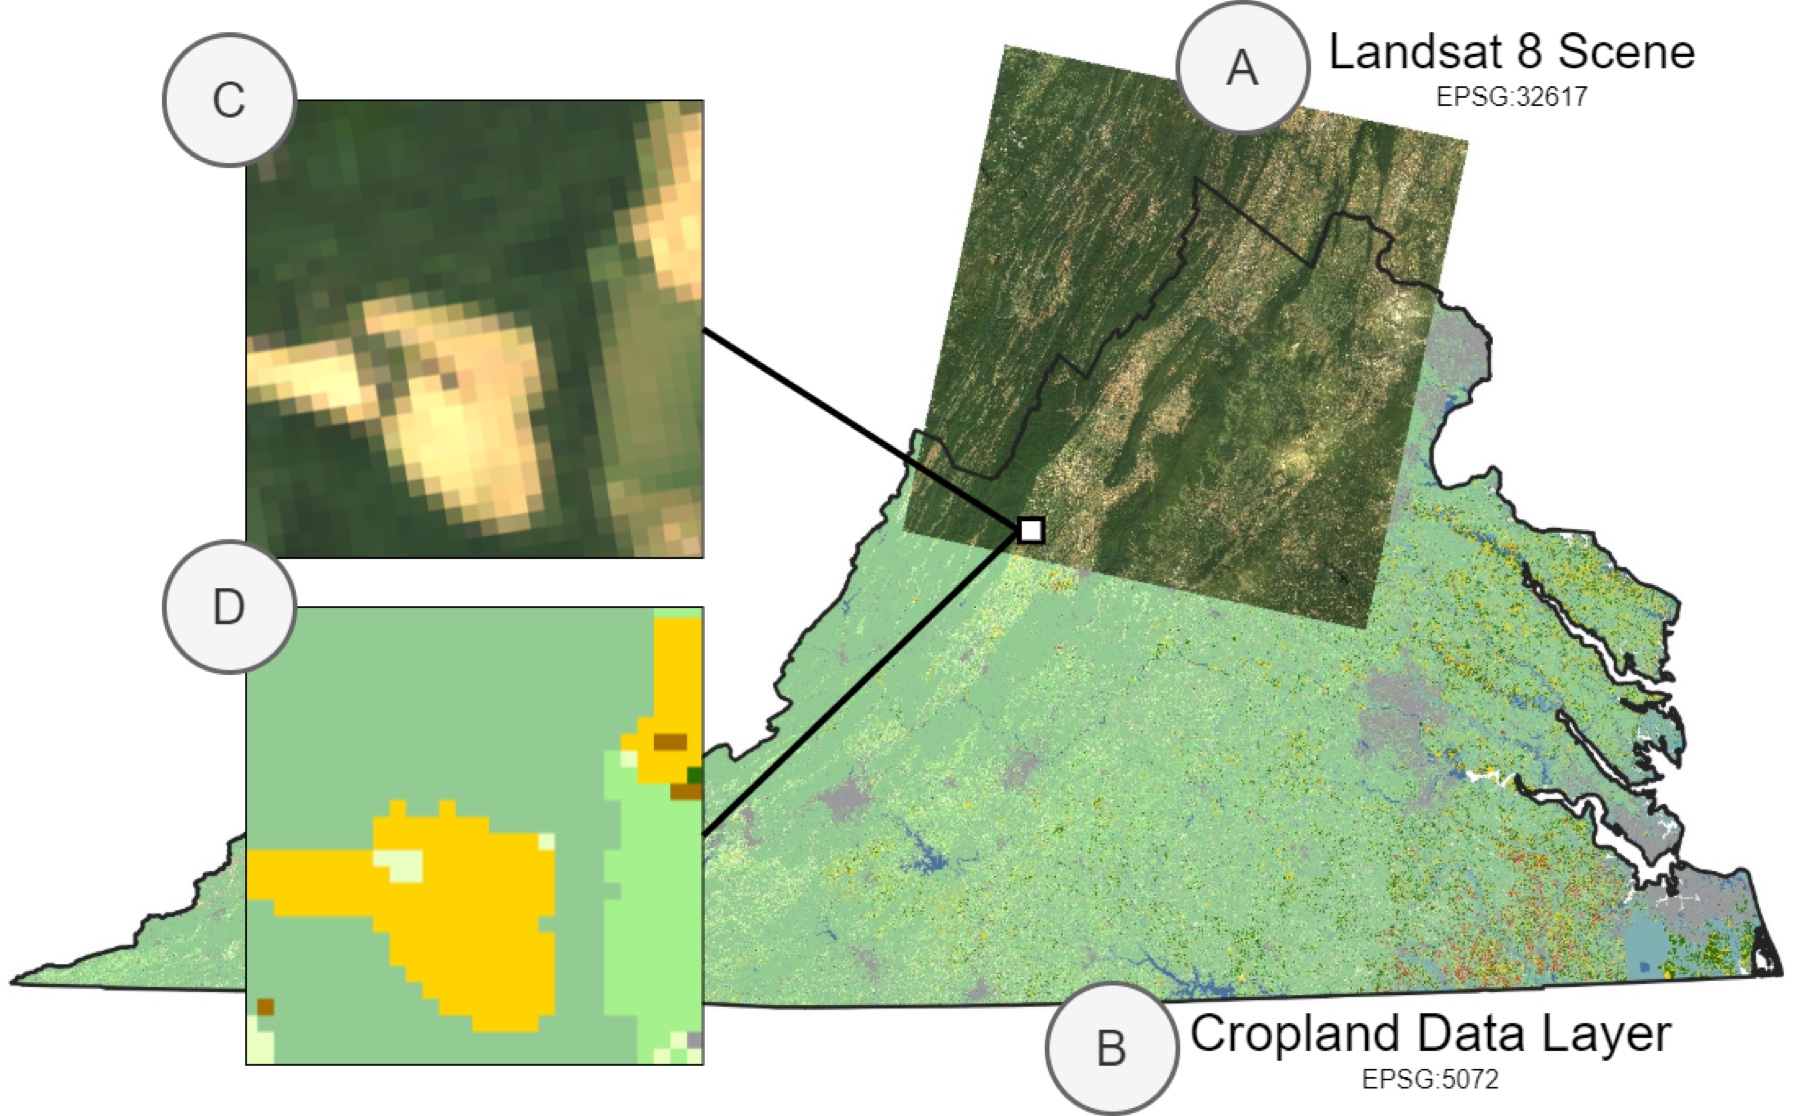 TorchGeo GeoDataset 示例:组合 Landsat 与 CDL 并采样训练 patch
这对工程团队的直接意义是:数据组织、采样策略和训练任务可以更清晰地分开。你可以先定义区域和时间窗口,再组合影像、标签和采样方式,而不是把大量规则写死在临时脚本里。对需要长期维护的自然资源监测、农业遥感、灾害复盘项目来说,这会降低脚本漂移和复现实验的成本。
技术路径:从 embedding 到业务图层
一个较稳的实施链路可以拆成六层。
第一层是影像与时间窗。团队先确认 AOI、影像来源、云量阈值、合成周期和目标季节,避免把不同物候、不同传感器条件下的结果直接混用。
第二层是 embedding 生成。使用 OlmoEarth Studio 或开源模型生成 COG,并把编码器版本、分辨率、时间范围、影像源和导出时间写入元数据。
第三层是 GIS 检查。用 GDAL、QGIS 或 rasterio 检查 CRS、bounds、nodata、波段数量、像元大小和基本可视化效果。这里的目标不是评价模型,而是确认输出可以被 GIS 正确读取。
第四层是轻量分析。根据任务选择相似性搜索、少样本分类、变化检测或 PCA 探索。少样本任务可以先用 scikit-learn 的线性模型验证可分性,不必马上训练复杂深度模型。
第五层是工程化训练。如果轻量验证有效,再用 TorchGeo 0.10 组织数据集、时空 sampler、任务模块、训练配置和评估指标,让实验可复现。
第六层是业务发布。把候选结果输出为 GeoTIFF、GeoPackage、PostGIS 图层或 WebGIS 服务,并标记“模型候选、人工复核、已确认、已驳回”等状态,避免模型输出直接变成业务结论。
GIS 团队怎么接入
一个现实可行的接入方式,不是立即替换现有遥感流程,而是做一个小闭环。
第一步,选一个业务边界清楚的区域和问题。例如:过去一年某类地表覆盖是否发生变化,某片农田是否与已有样本相似,或某个湿地区域是否出现异常斑块。
第二步,用 OlmoEarth Studio 或开源模型生成 embedding COG。生成时要记录 AOI、时间范围、影像源、分辨率、编码器版本和参数。没有这些记录,后续结果很难复核。
第三步,用 QGIS、GDAL 或 rasterio 检查数据。重点看 CRS 是否与业务底图一致,nodata 是否处理正确,像元分辨率是否适合目标尺度,云覆盖或缺失观测是否影响判断。
第四步,选择轻量任务验证价值。可以先做相似性搜索,找出“像这块样本地”的区域;也可以用少量人工样本训练线性分类器,快速生成候选图层;变化检测则可以比较两个时间段 embedding 的距离,把疑似变化区交给人工复核。
第五步,如果试点有效,再用 TorchGeo 0.10 组织训练任务。这里更适合做长期化:固定数据集版本、采样策略、训练配置、验证指标和输出路径,让模型迭代能被追踪,而不是每次都重新拼脚本。
适合哪些场景
自然资源巡查适合从相似性搜索开始。先选典型建设扰动、裸地、林地退化或湿地斑块,找出相似区域,再交给人工或规则模型复核。
农业遥感适合从时序特征切入。作物类型、长势异常、收获进度和灌溉差异都依赖季节变化,单景影像容易受云和物候影响。TorchGeo 0.10 的时序任务和 sampler 对这类场景更有价值。
灾害与应急适合从变化检测切入。洪水、火烧迹地、滑坡、道路中断等问题不一定需要一开始就训练复杂模型,先用前后时相 embedding 差异锁定候选区,再叠加地形、道路和行政区图层,往往更快进入业务判断。
企业 GIS 和园区管理则可以把 embedding 看成影像资产的二级索引。它不一定直接出结论,但可以帮助快速检索相似地物、发现异常变化、筛选人工核查范围。
落地风险
第一,embedding 不是事实本身。它是模型学到的表征,仍然需要样本、规则或人工复核来解释。不能把“向量相似”直接等同于“业务对象相同”。
第二,影像质量会影响结果。AllenAI 文章明确提示,持续云覆盖、大气伪影或合成期缺失观测都会影响 embedding 质量。GIS 团队要把云量、时间窗和影像来源写进结果说明。
第三,尺度不匹配会制造假精度。10 米、20 米、40 米、80 米分辨率适合的问题不同。用低分辨率 embedding 判断小尺度违建、窄道路或细碎地块,会让地图看起来很完整,但业务上并不可靠。
第四,TorchGeo 0.10 有迁移成本。release notes 提到 trainers 子包改名为 tasks,samplers 也经历重构。已有训练脚本升级时要逐项检查 import、采样逻辑、样本字典和依赖版本。
第五,输出图层需要治理。embedding COG、候选变化图、少样本分类图都应该标注模型版本、数据时间、处理参数和复核状态。没有这些元数据,后续进入业务系统会出现责任不清。
下周可以做什么
如果团队想低成本验证,可以用一周做一个最小试点。
第一天,选定一个 AOI 和一个问题,只保留一个业务目标,例如“识别近一年新增疑似裸地”。
第二天,生成或获取 embedding COG,并用 GDAL/QGIS 检查 CRS、分辨率、nodata、波段数量和可视化效果。
第三天,准备 30 到 100 个样本点或样本面,覆盖正例、负例和容易混淆的地物。
第四天,用 rasterio 和 scikit-learn 做一个线性分类或相似性搜索,把结果输出为 GeoTIFF 或 GeoPackage。
第五天,在 QGIS 或 WebGIS 中叠加业务底图、行政区、历史影像和人工复核结果,记录命中、漏判、误判和原因。
这类试点不追求一步到位。它的目标是验证三件事:embedding 是否真的降低样本需求,GIS 工具链是否能顺畅读取输出,业务人员是否能根据候选图层做出更快、更稳的判断。
资料来源
- Hugging Face / AllenAI:Introducing OlmoEarth embeddings: Custom embedding exports from OlmoEarth Studio for downstream analysis,2026-08-12,https://huggingface.co/blog/allenai/olmoearth-embeddings
- TorchGeo:TorchGeo 0.10.0 Release Notes,2026-08-14,https://github.com/torchgeo/torchgeo/releases/tag/v0.10.0
- TorchGeo README,https://github.com/torchgeo/torchgeo
- GDAL Documentation,https://gdal.org/en/stable/
- Google Earth Engine release notes,https://developers.google.com/earth-engine/docs/release-notes